
如何把 HPN 多平面的带宽,真正转化为 AI 任务的通信效率?
作者:xxinjiang2026.09.22 09:50浏览量:3简介:本文从端侧和网侧两条线,拆解了逐包 / Cell 级的细粒度负载均衡和逐流的选路策略优化方案。
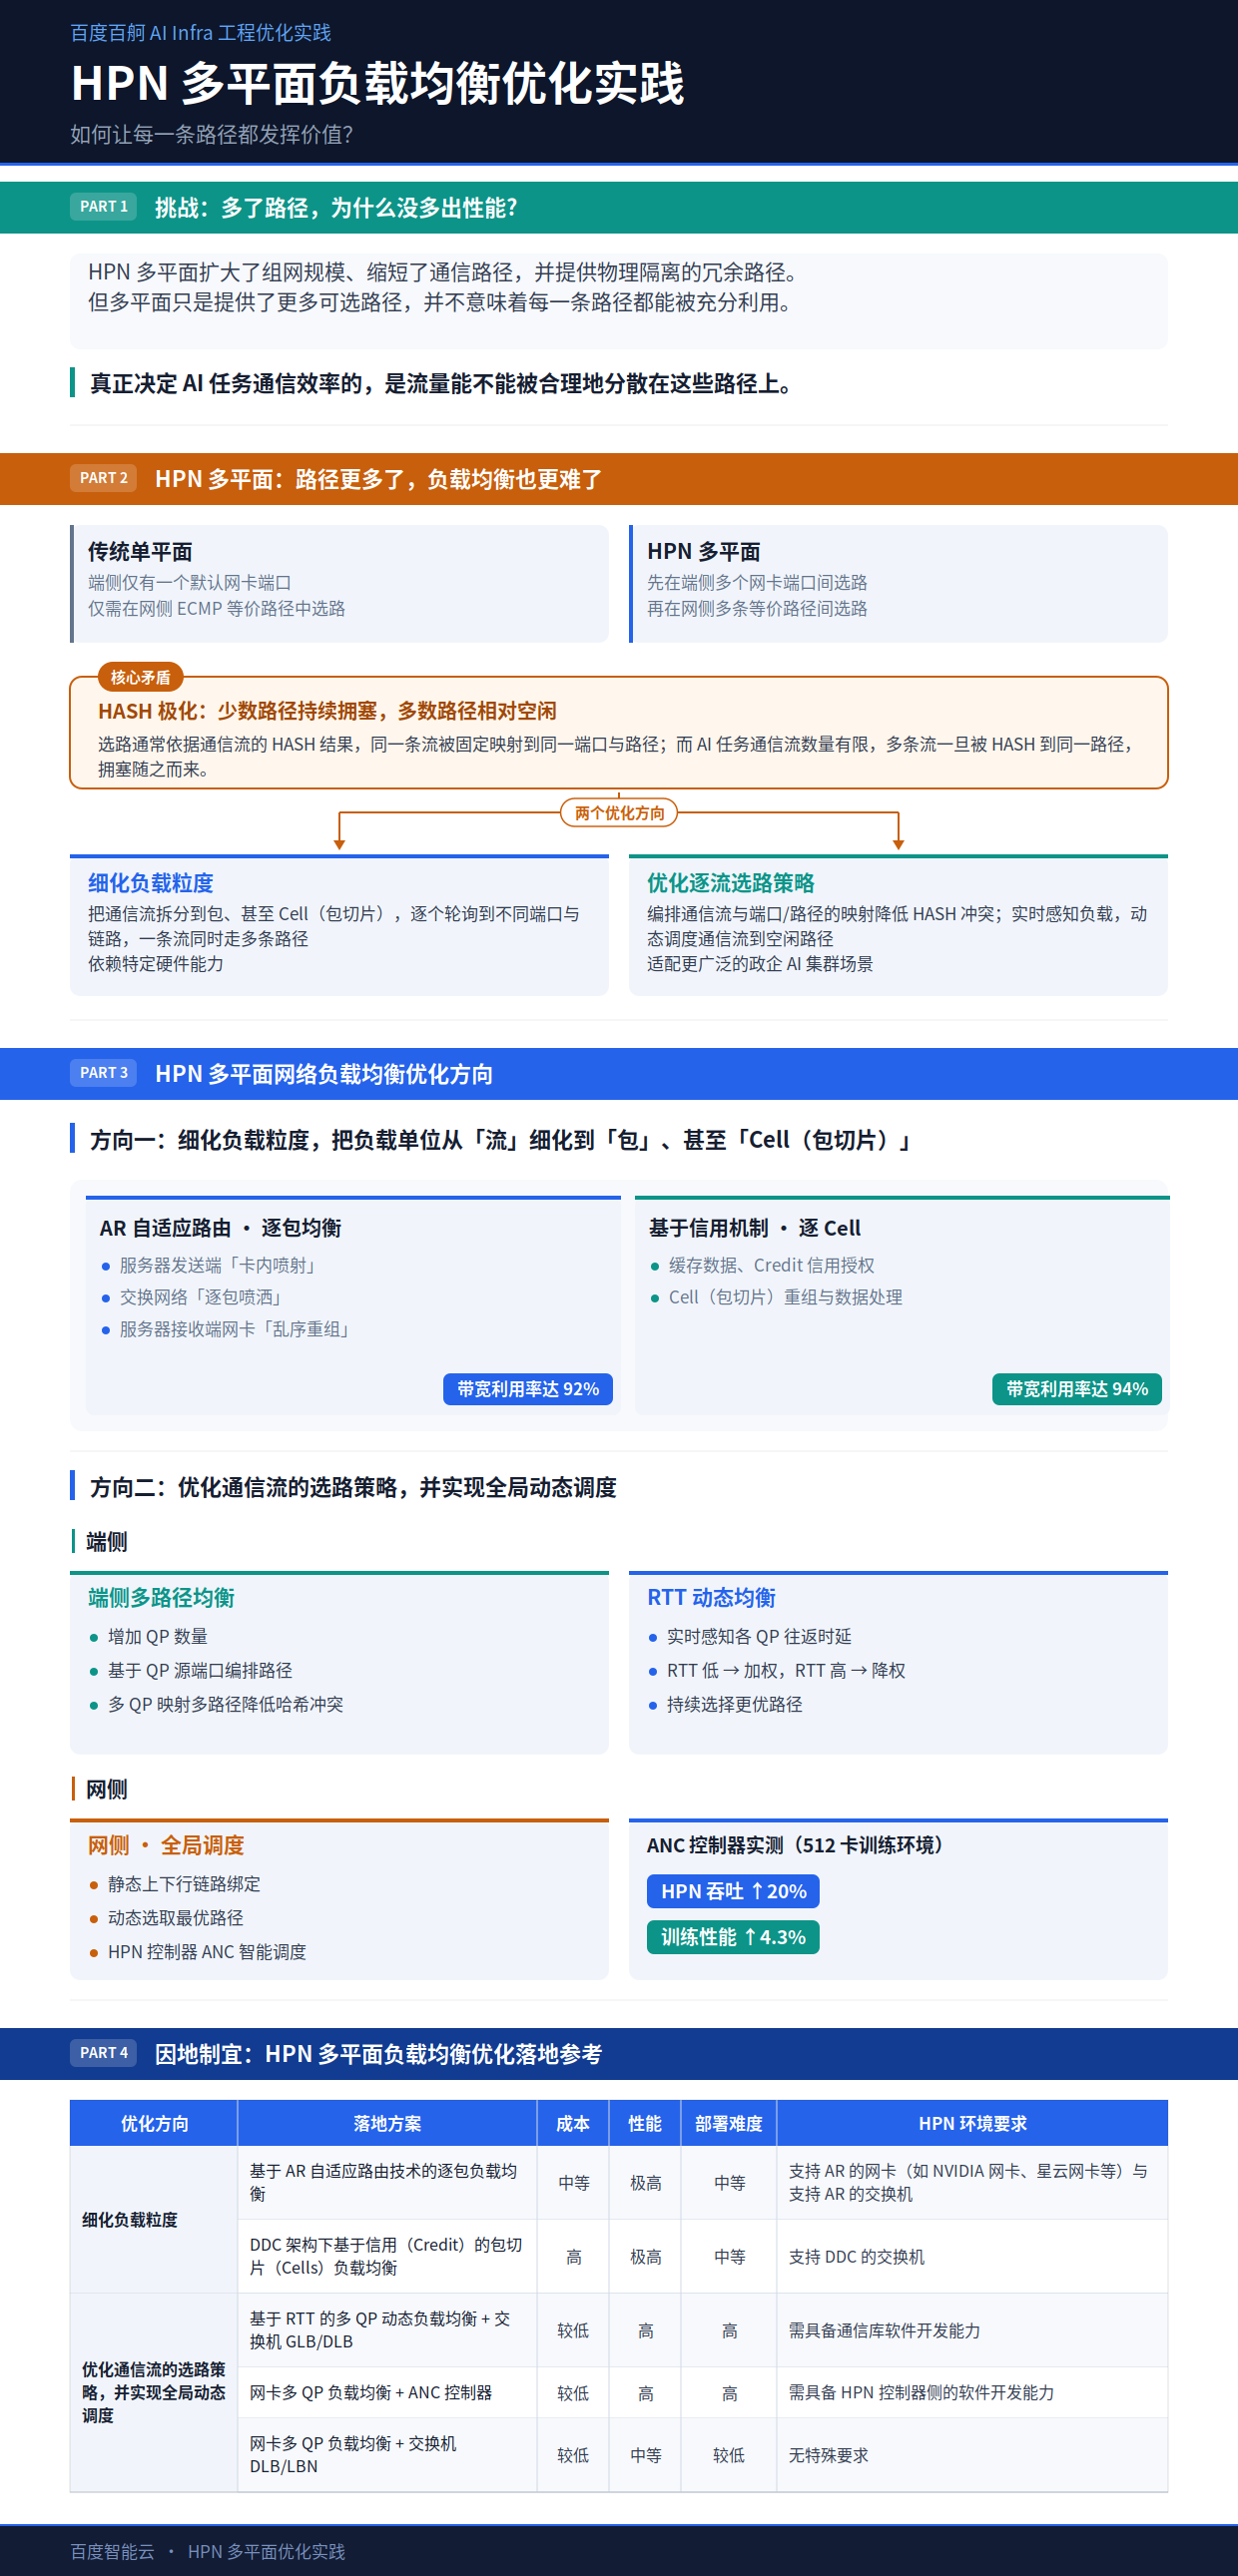
在大规模 AI 集群建设里,HPN 多平面组网正被越来越多地采用。它通过多网卡/多端口、多组交换机,构建多个并行转发的网路平面,让同一通信任务可以跨平面分散传输。它一方面能扩大组网规模、缩短通信路径、降低时延;另一方面,多平面之间天然形成物理隔离的冗余路径,故障时可以快速切换。
但多平面只是提供了更多可选路径,并不意味着每一条路径都能被充分利用。真正决定 AI 任务通信效率的,是流量能不能被合理地分散开、避免少数路径持续拥塞而多数路径空闲,从而把多平面的带宽真正用起来。
围绕这一问题,百度智能云面向典型的 AI 集群网络基础设施场景,整合通信库、网卡、交换机等软硬件能力,为 HPN 多平面负载均衡提供两类优化方向:一是细化负载粒度,二是优化逐流选路策略并实现端网协同的动态调度。
下面我们结合落地实践,拆解 HPN 多平面负载均衡的实现路径和优化方案,并给出不同场景下的选型参考。
1. HPN 多平面:路径更多了,负载均衡也更难了
HPN 架构中,一个通信流从源 AI 加速卡到目的 AI 加速卡,需要经过服务器网卡、接入交换机和骨干网络等多级转发。
在传统的 HPN 单平面网络里,流量在服务器端侧只有一个默认的网卡端口,数据流量到交换机网络中才需要在等价路径(ECMP)中进行选路。
但进入多平面后,数据流先要在端侧的多个网卡端口之间选路,再到网侧的多条等价路径之间选路。
这两类选路共同决定了 HPN 多平面网络的负载均衡效果,也直接影响网络带宽利用率和 AI 任务通信效率。
HPN 的选路通常依据通信流的 HASH 计算结果。在没有额外编排的情况下,同一条流的 HASH 值是固定的,也就会被映射到固定的端口和路径上。而 AI 任务的通信流数量本就有限,多条流一旦被 HASH 到同一条路径,就极易出现 HASH 极化,即少数路径持续拥塞,多数路径相对空闲。
要让流量更均衡地分散开,最直接的思路便是细化负载粒度:把原本作为一个整体的通信流,拆分到数据包、甚至 Cell(包切片)。同一个通信流里的包或 Cell,可以按序依次轮询到不同的服务器端口上,再依次轮询到不同的网络链路上,而不是像逐流模式那样,整条流被 HASH 固定在一条路径上。如此一来,一条流也能同时走多条路径,多条流之间也不再因为 HASH 冲突而挤在同一条路上,从而把 HPN 多平面的带宽充分利用起来。
当然,不论是逐包还是逐 Cell,都需要特定的硬件能力支持,并非所有政企客户的 AI 基础设施都能满足。
因此,面向政企客户更为广泛的 AI 集群场景,百度智能云也提供了逐流选路策略的优化,使每条流选择的端口或路径更为合理。比如,编排通信流与端口/路径的映射关系,降低 HASH 冲突;再如,通过对端口或路径的实时负载感知,动态调度通信流到空闲路径。
接下来,我们结合具体的技术方案详细阐述这两种 HPN 多平面网络负载均衡优化方向。
2. 方向一:细化负载粒度,把单条流打散到多条路径
对于追求极致网络性能、具备特定硬件能力的场景,可以将负载均衡粒度从「流」细化到「包」甚至进一步细化到「Cell」,通过端到端的逐包、逐 Cell 负载均衡提升多平面带宽利用率。
此时,由于通信流被打散后在不同端口/链路上依次发送,数据包到达对端网卡的先后顺序很可能是错乱的,这就要求 AI 集群的网络硬件具备「乱序重组」的能力。
该类负载调度技术实践的典型代表是「基于 AR(Adaptive Routing)自适应路由技术的逐包负载均衡」和 「DDC 架构下基于信用(Credit)的包切片(Cells)负载均衡」。
2.1. 基于 AR 自适应路由技术的逐包负载均衡
基于 AR 自适应路由技术的逐包负载均衡,由端侧网卡和网侧交换机在硬件层面协同完成。发送端给包打上乱序标记并分散到多个端口,交换机再根据链路状态把包逐包转发到不同路径,接收端负责乱序重组。
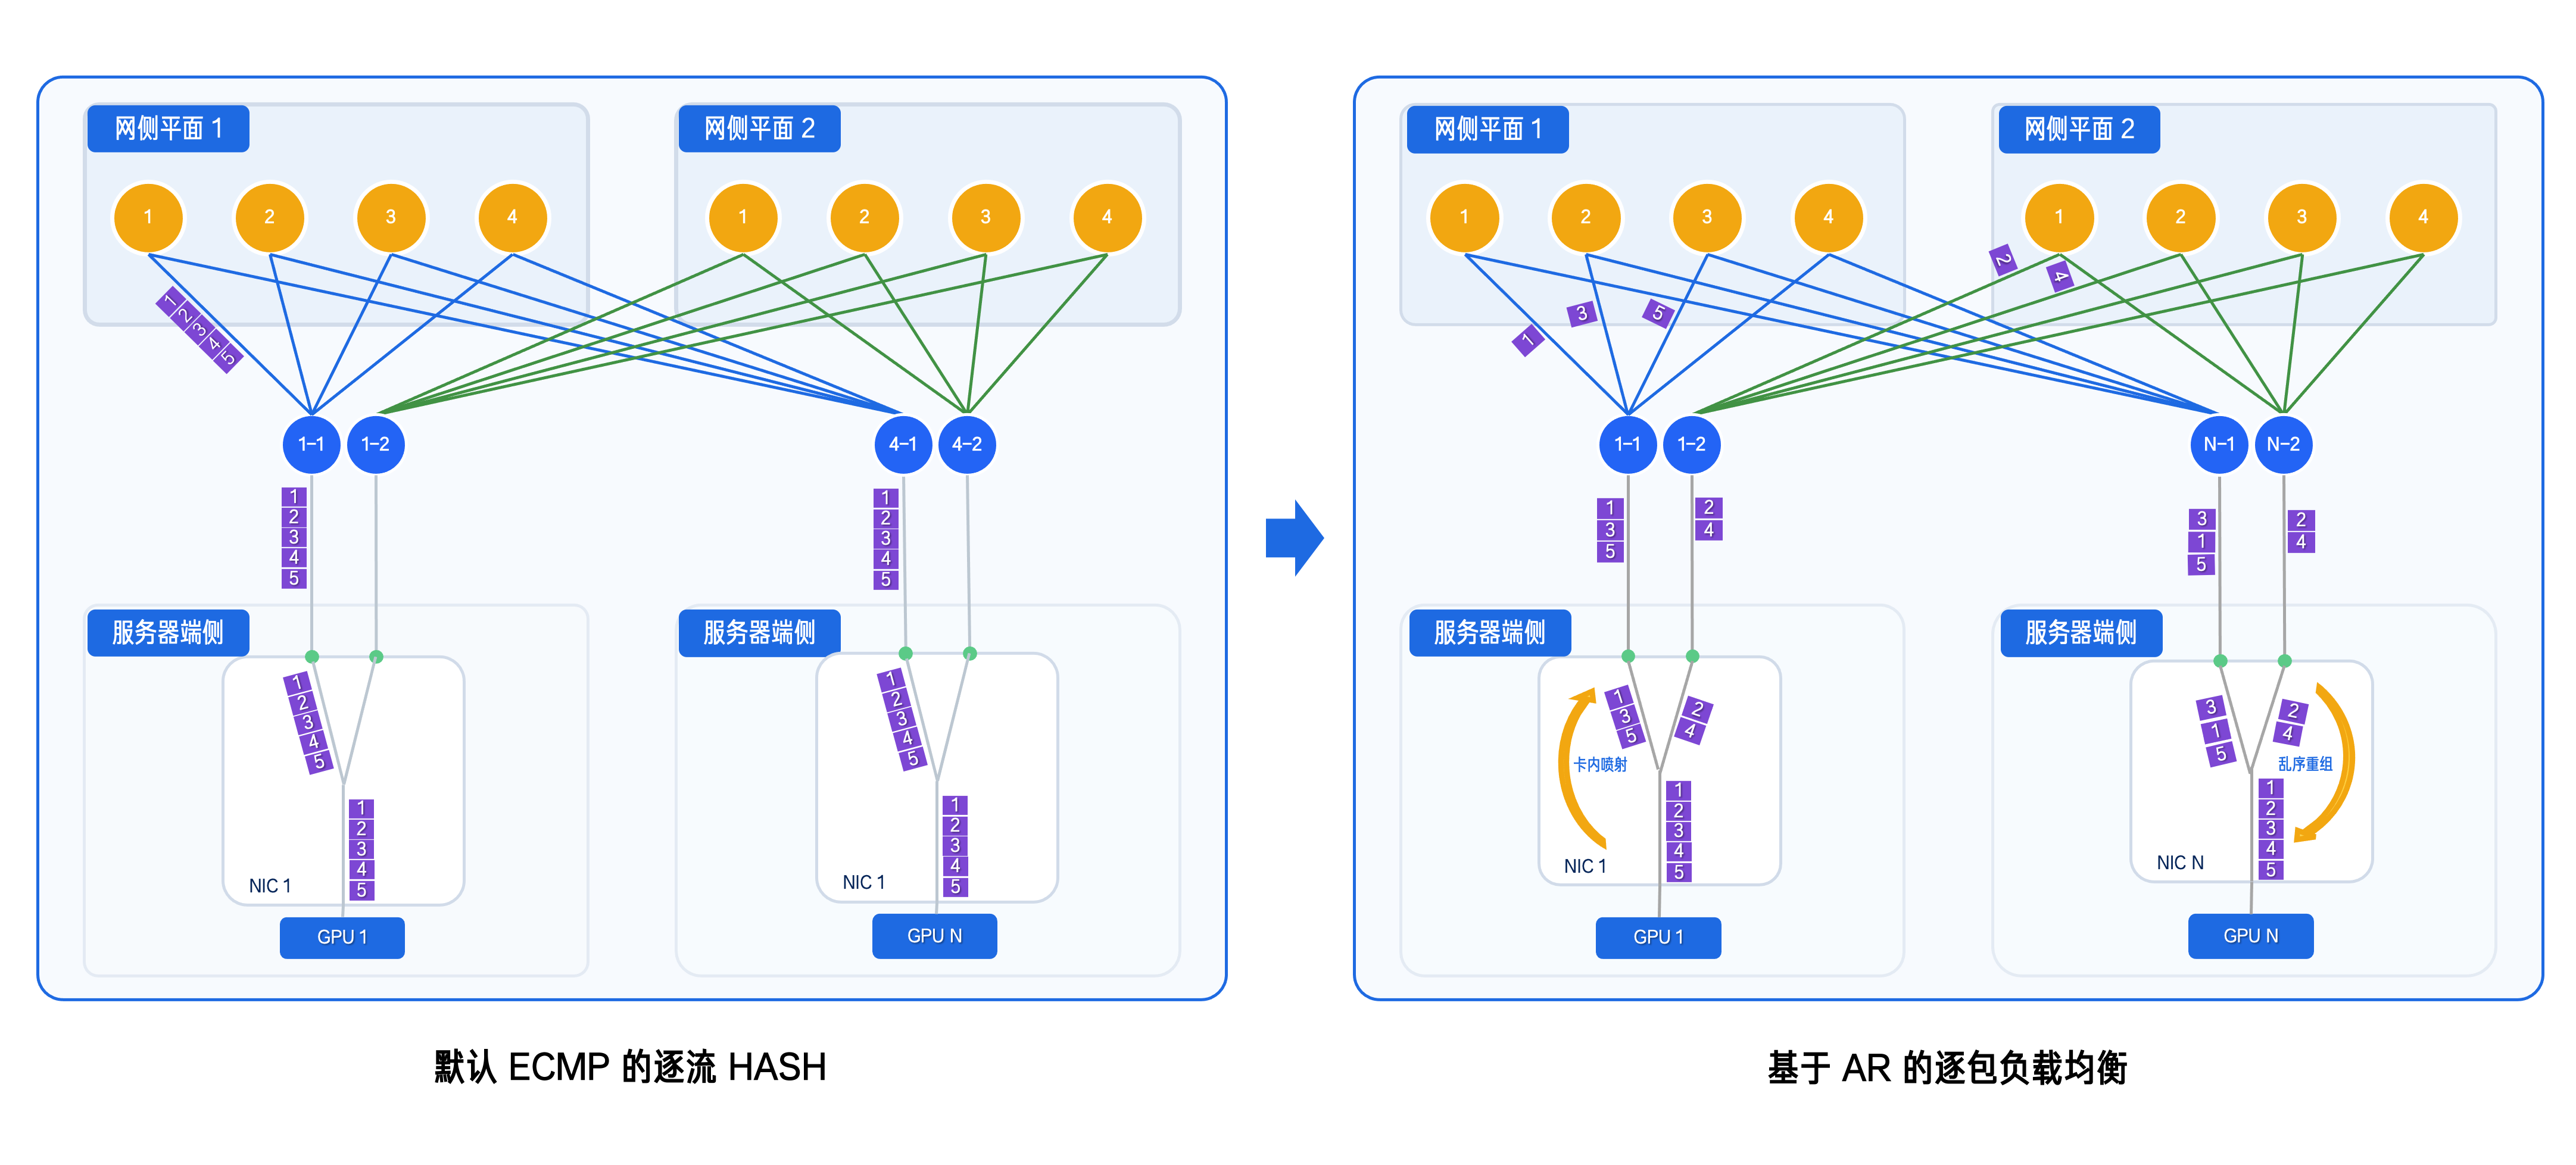
具体过程如下:
- 服务器发送端「卡内喷射」:发送网卡在每个数据包中携带目标内存地址,带上「允许乱序」的标签,然后把同一条流的包均匀喷洒到不同的网卡端口上;
- 交换网络「逐包喷洒」:交换机识别乱序标记后,也同样将数据包均衡分布到不同的 ECMP 链路,充分利用整个网络带宽;
- 服务器接收端网卡「乱序重组」:由于每个乱序报文都携带目标内存地址,在确认同一块数据的所有包完整落位到网卡 Buffer 后,再写入 HBM,从而保证最终的数据一致性。
虽然数据包乱序重组会带来额外等待开销,引起大约 3% 的性能损耗。但 AR 能使网络持续维持较高的带宽利用率和均衡度,网络带宽利用率可高达 92%,相比传统 ECMP 负载均衡方案提升 25%+ 带宽利用率。
2.2. DDC 架构下基于信用(Credit)的包切片(Cells)负载均衡
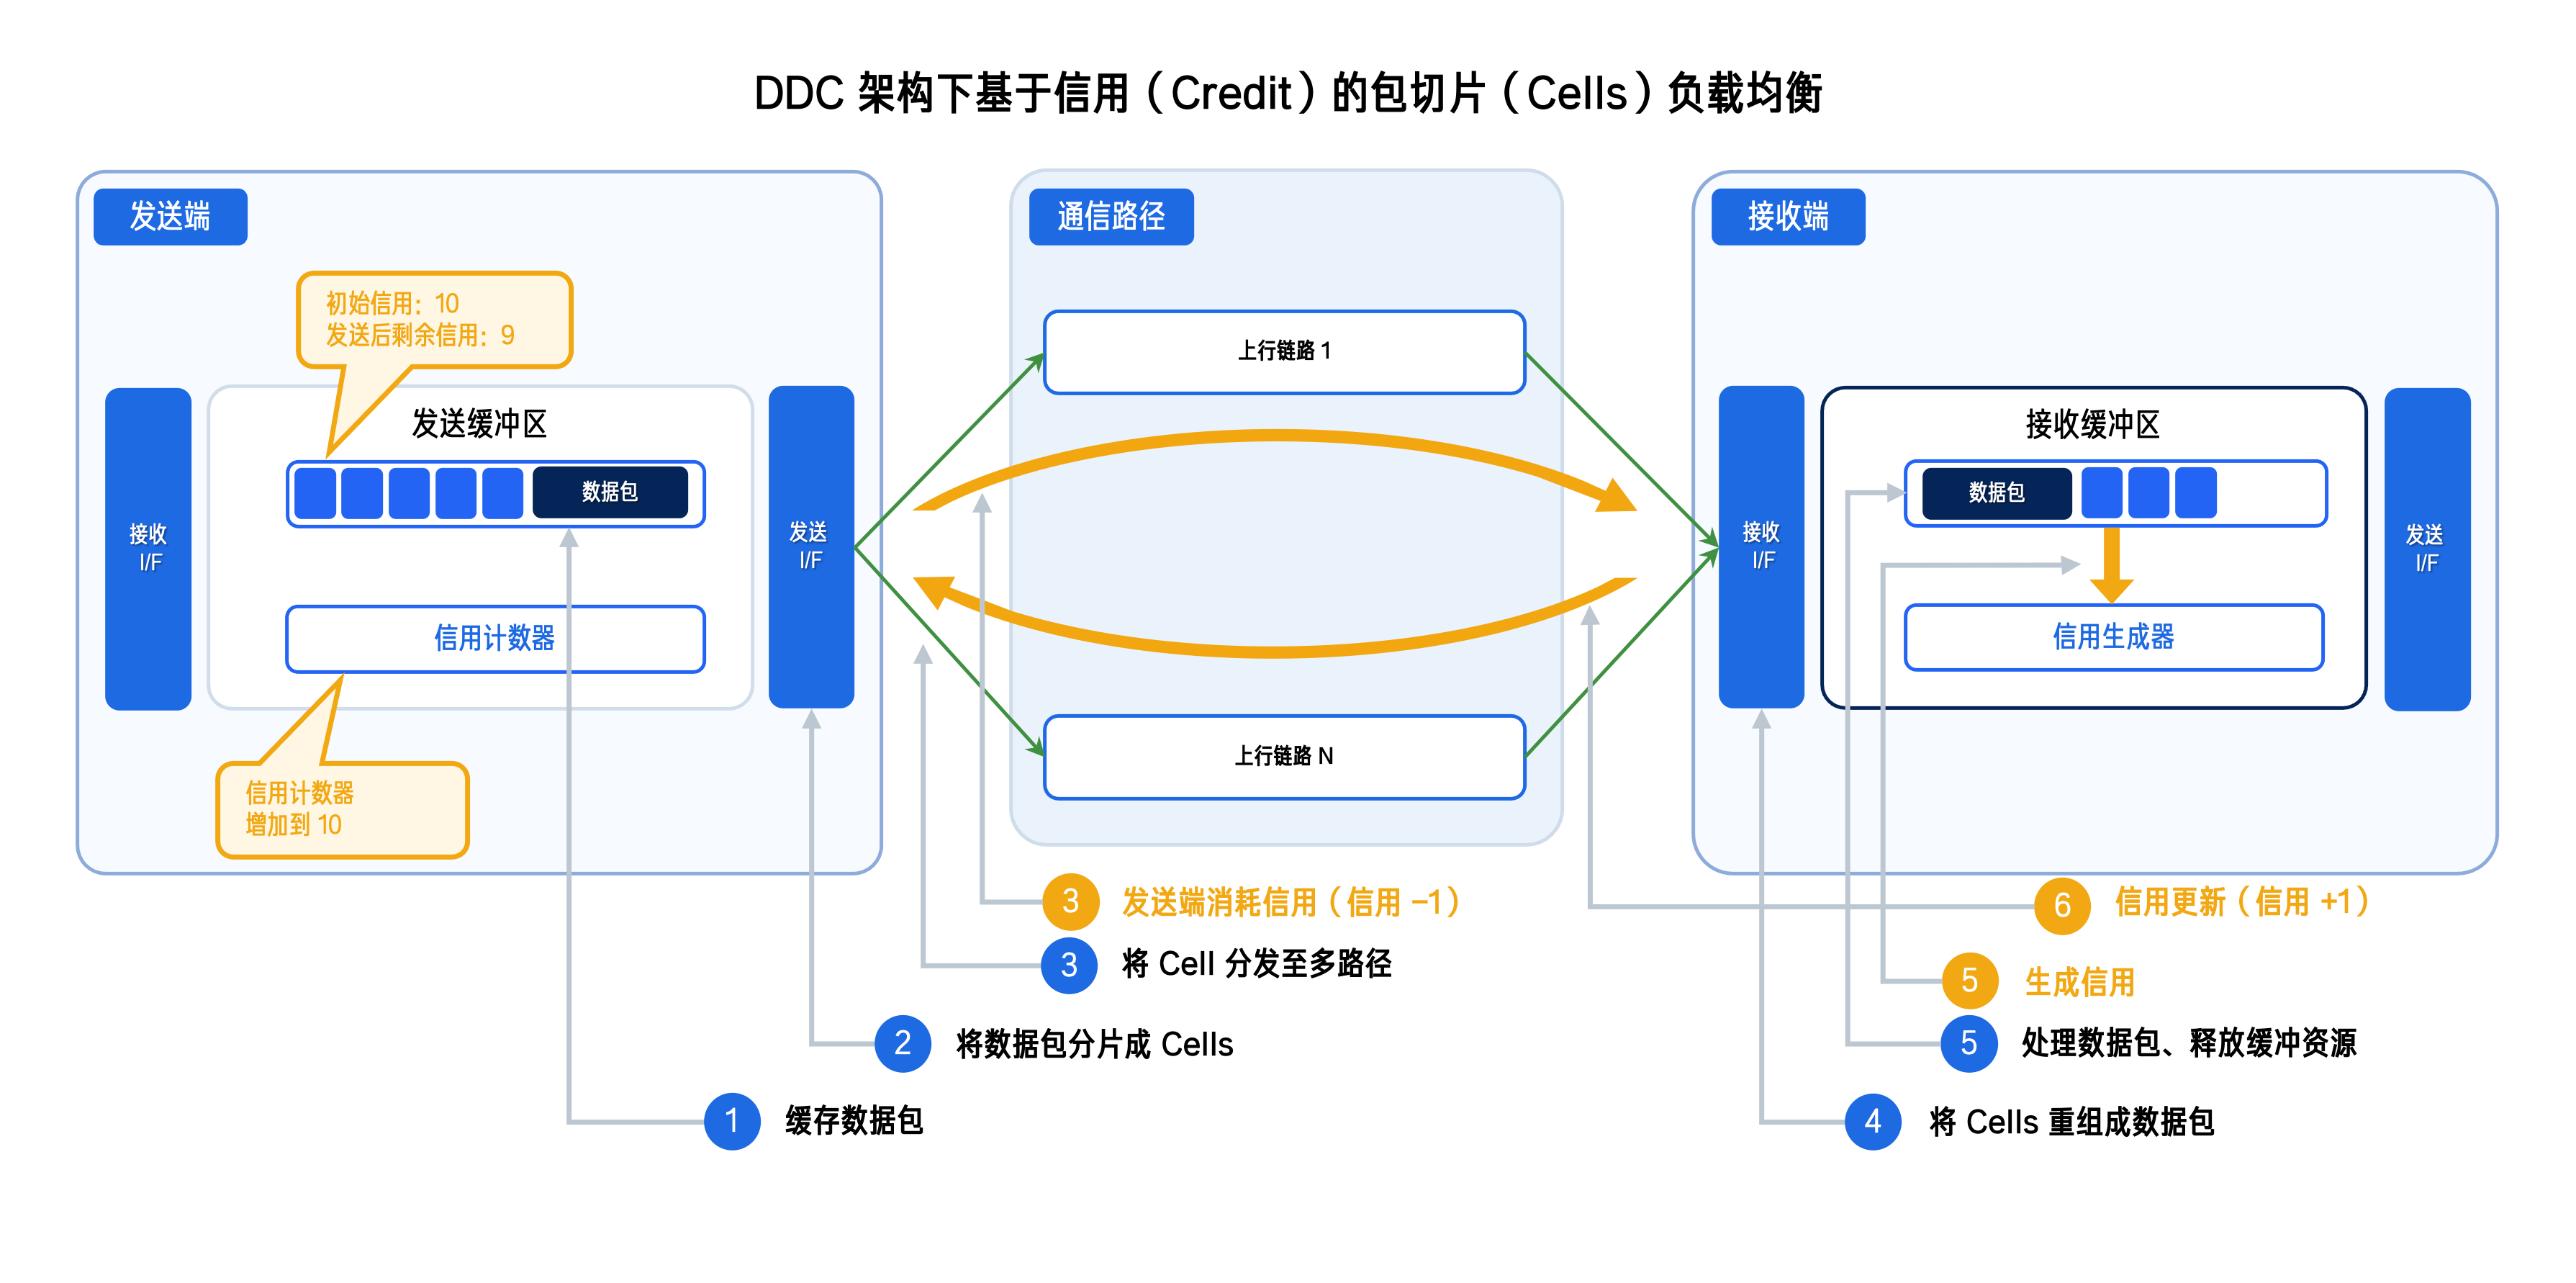
基于信用的包切片负载方案与 AR 负载均衡的整体思想类似,都是把流量拆到更细粒度后分散到多条路径。其区别主要在两点:
- 第一,DDC 的负载粒度更细。AR 负载均衡以包为单位,数据包大小通常为 1500-4000 Byte;DDC 以 Cell 为单位,大小通常为 64-256 Byte;
- 第二,DDC 采用基于信用的转发机制,这一点更为关键。发送端能发多少数据,取决于接收端给出多少授权额度。发送端先把数据放入本地「发送缓冲区」,确认有足够信令后,再把数据切分成 Cell 发送;接收端完成 Cell 重组和数据处理后,释放缓冲资源,并更新信用额度。这种机制让发送速率和接收侧的处理能力匹配,有效避免了交换网络内部的拥塞。
因此,DDC 架构下基于信用(Credit)的包切片(Cells)负载均衡方案也依赖支持信用机制与包切片「乱序重组」机制的特定硬件。
实测显示:该方案的网络带宽利用率可高达 94%,相较传统 ECMP 负载均衡方案提升 27%+ 带宽利用率。
3. 方向二:优化逐流选路策略,实现端网协同的动态调度
对于 AI 集群中更常见的逐流负载均衡场景,百度智能云针对 HPN 多平面的端侧和网侧两类选路过程分别进行优化:
- 端侧通过增加 QP (Queue Pair,RDMA 通信中的队列对)等逻辑通道,扩大流量可选择的路径,并通过路径编排实现均衡,同时基于 RTT 等动态感知方式实时调整流量权重;
- 网侧则利用交换机的动态负载均衡能力,结合 HPN 的 ANC(Adaptive Network Congestion,自适应网络拥塞)控制器持续感知网络拥塞,把热点流量及时疏散到空闲路径。
端侧优化:基于 RTT 的动态负载均衡
在默认 RDMA 通信机制下,每对 GPU Rank 通过预先建立的 RDMA QP 进行通信。同一个 QP 对应固定的五元组信息,因此通信流一旦建立,其进入网络平面的路径通常不再变化。当多条流集中映射到同一网络端口时,容易形成链路拥塞。
百度智能云优化路径分 3 步展开:
- 增加 QP 数量,并平衡性能与开销。传统通信模式下,一对 GPU Rank 之间默认仅建立少量 QP,可参与 HASH 的通信路径有限。增加 QP 数量可以拓宽可选路径,让 HASH 结果更离散。但 QP 数量并非越多越好,对不同厂商的多款主流 RDMA 网卡测试后发现:部分网卡在 QP 数量达到数千后便会出现明显的性能衰减。结合当前多数训推任务的通信规模,每对 Rank 建立 8 个 QP 已能满足需求,同时可以有效控制网卡的处理开销,在负载均衡效果与网卡性能之间取得较好平衡。
- 让 QP 均匀分布到多平面上:增加 QP 后,还需要保证这些 QP 能够均匀分布到不同网络端口。其实现方案有两种:基于网卡硬件能力,通过 Queue Affinity 等技术自动完成 QP 在各端口间的散列和均分;基于通讯库,可以结合服务器和交换机的 HASH 算法,在通信库中指定每个 QP 的源端口号,有规划的把不同的 QP 编排到不同的物理链路上。
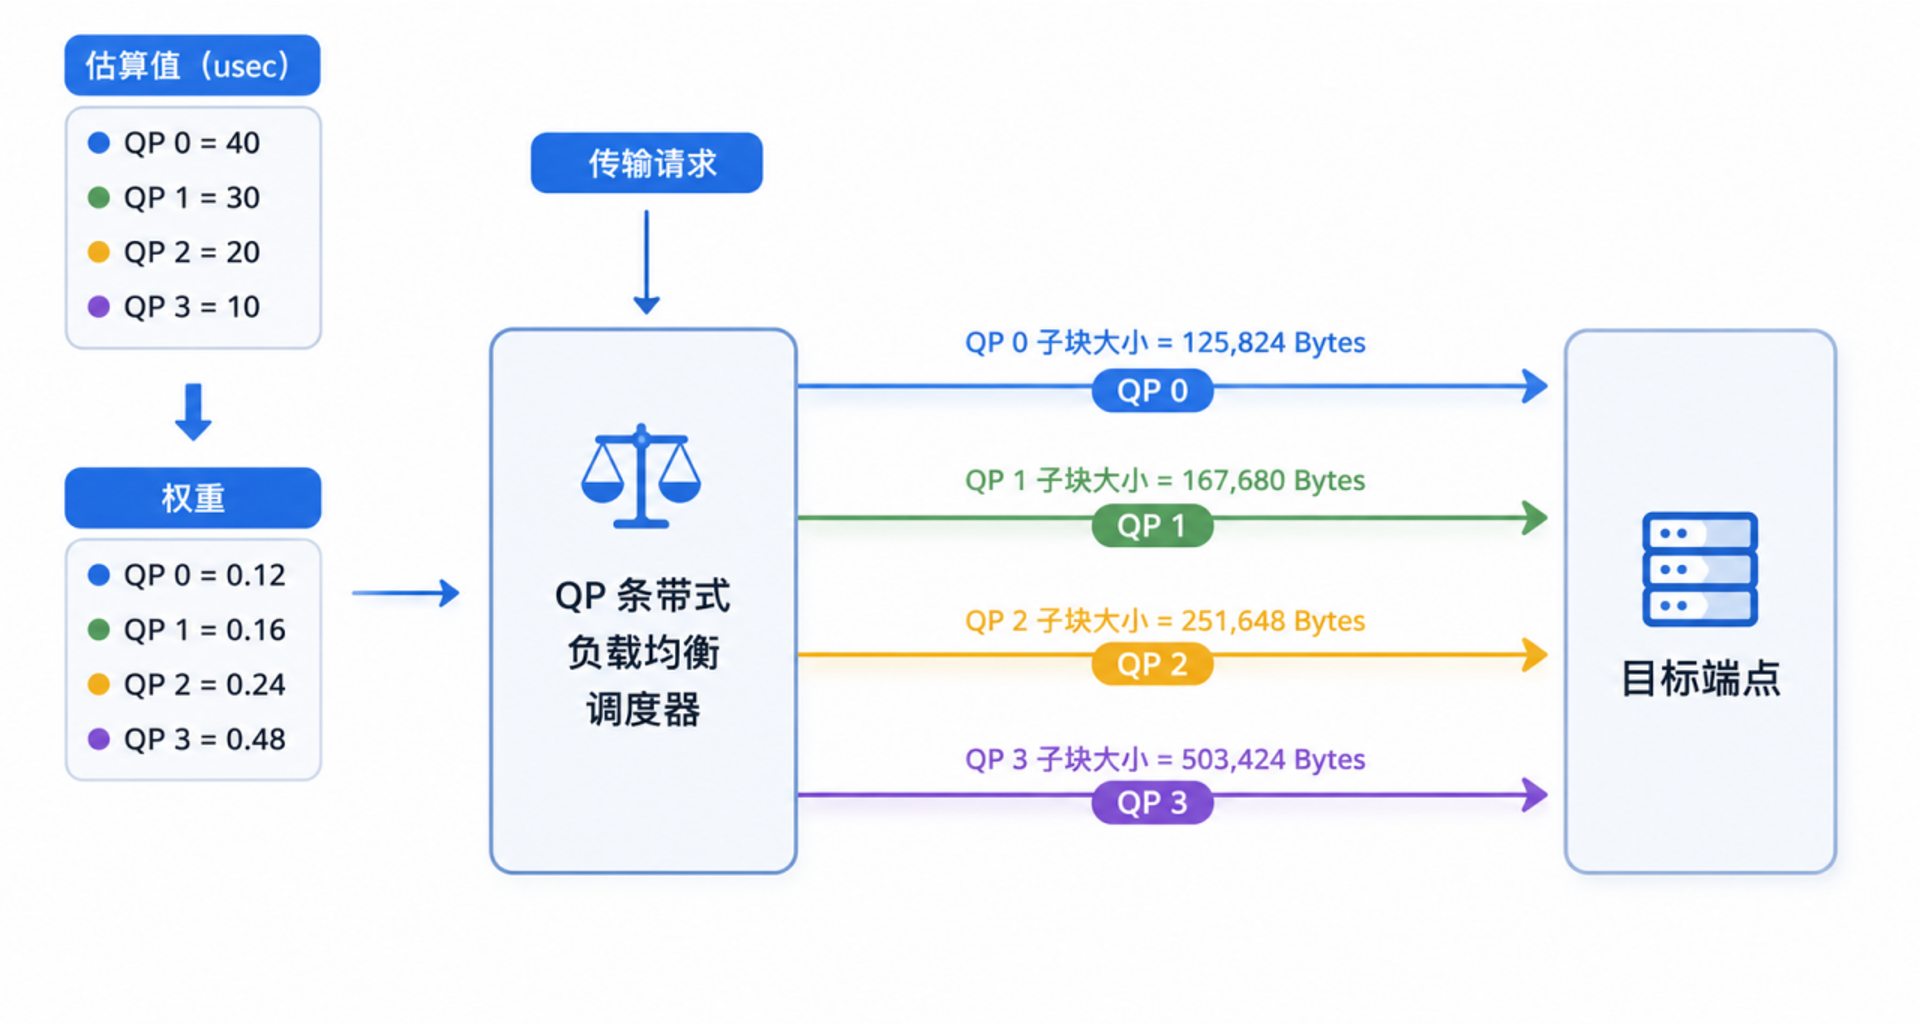
- 基于 RTT 动态调整 QP 的带宽权重:静态分配只能实现初始均衡,无法适应训练和推理过程中不断变化的网络负载。为此,可以进一步引入基于 RTT(Round Trip Time,往返时间)的动态负载均衡机制,实时感知每条 QP 的通信时延,并根据 RTT 动态调整不同 QP 的流量权重:RTT 越低,说明链路负载越轻,则赋予更高的流量权重;RTT 越高,则适当降低其承担的通信比例。借助这一机制,通信流能够随着网络状态持续选择更优路径,在 QP 粒度实现动态均衡。
网侧优化:全局动态负载与智能拥塞调度
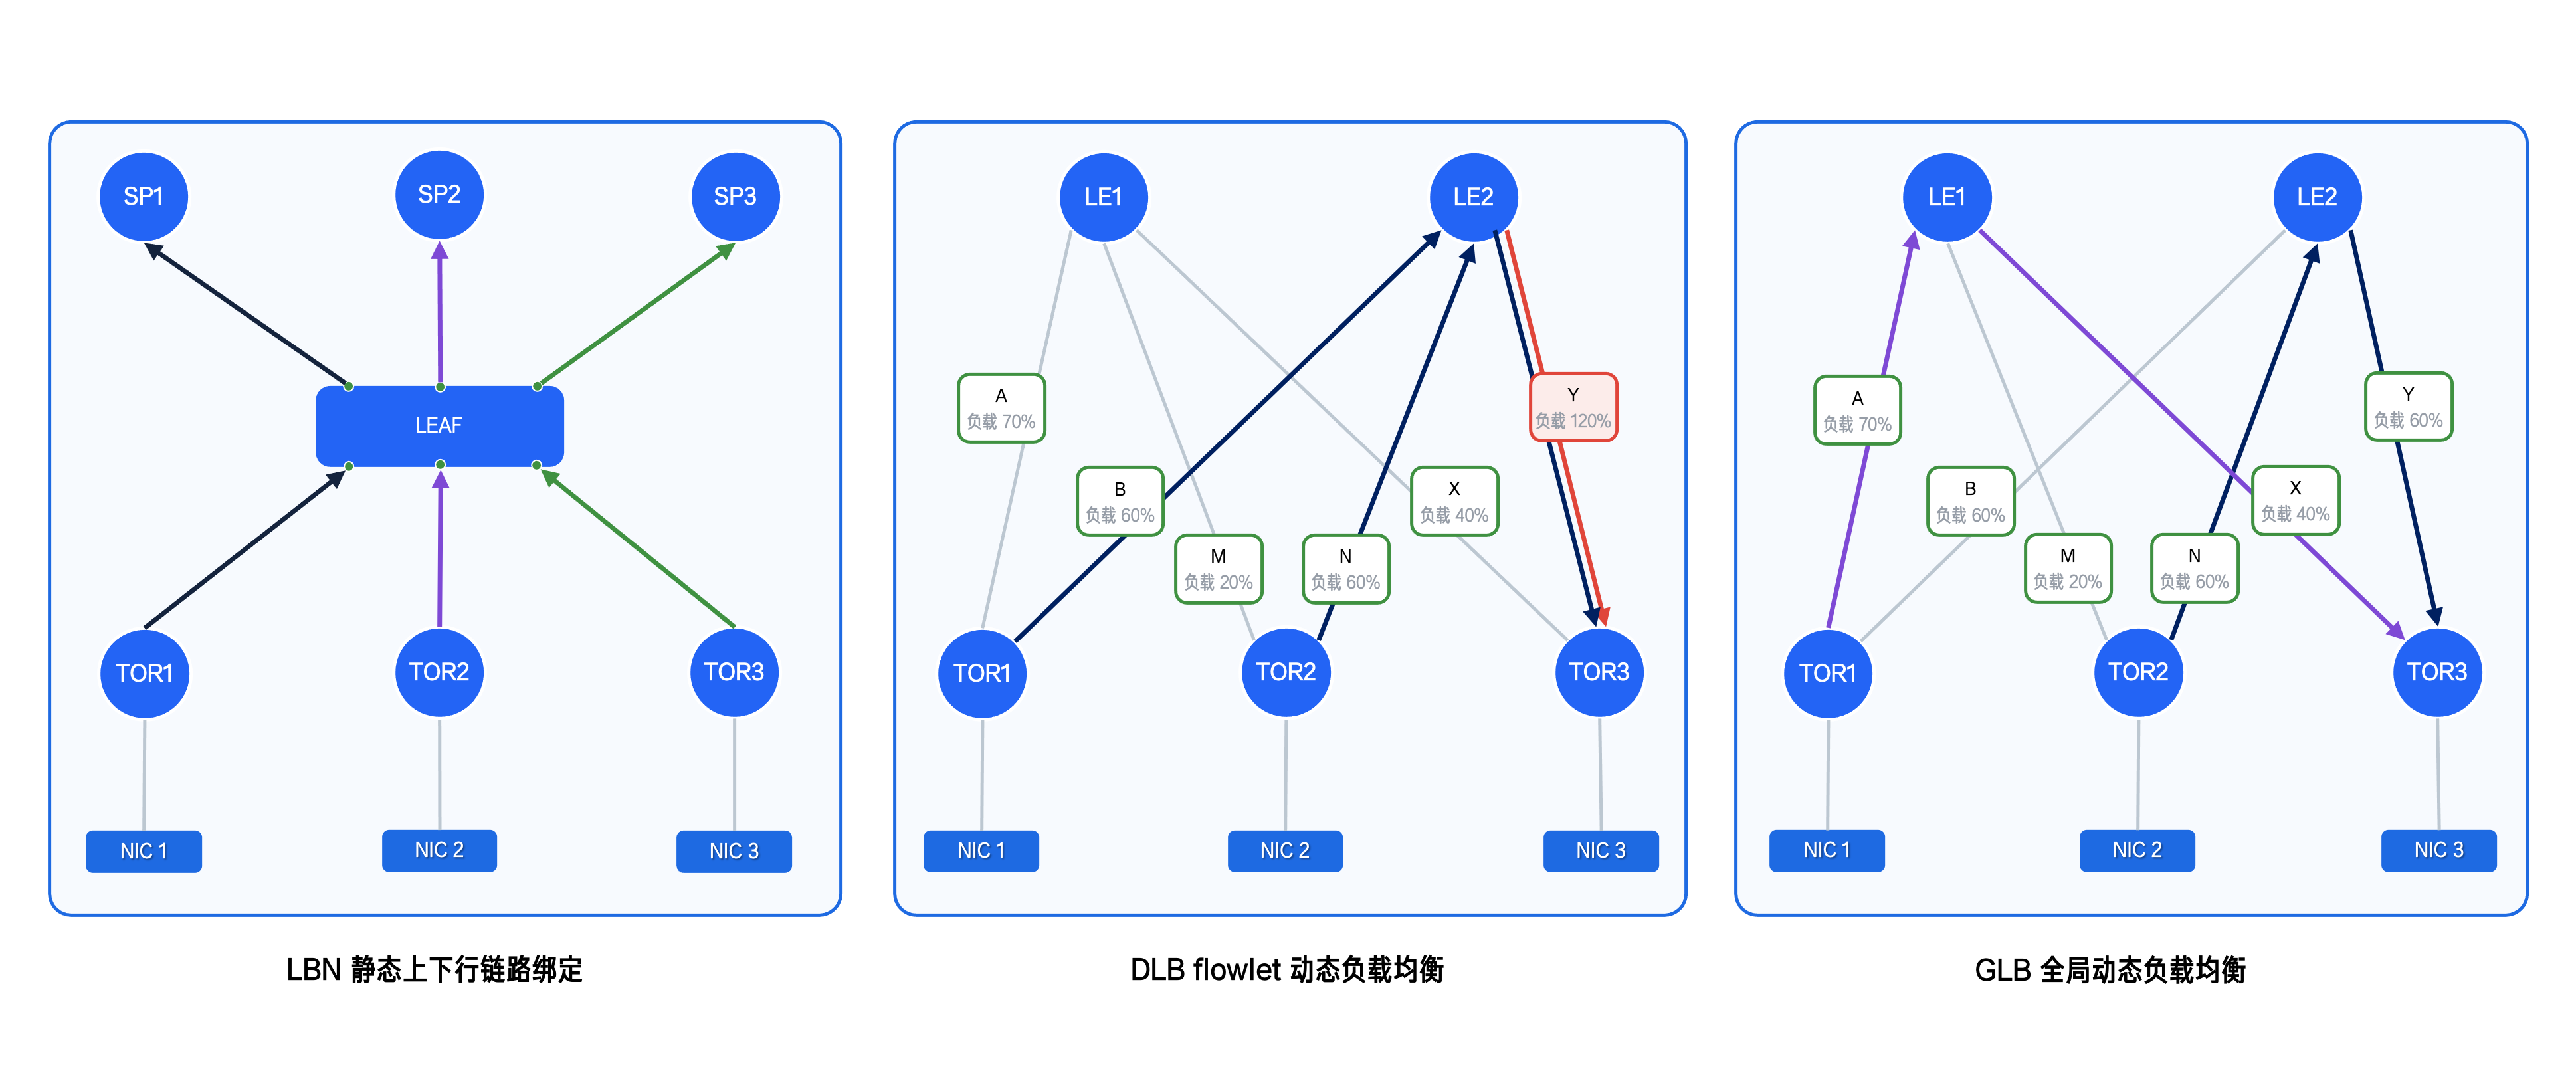
目前,主流交换机已提供多种逐流负载均衡机制,常见的有上下行链路绑定(LBN)、 逐流动态负载均衡(DLB flowlet)和全局逐流动态负载均衡(GLB)。
- 上下行链路绑定(LBN):实现简单、部署成本低,适合拓扑相对固定的场景。但它采用固定映射,链路故障时流量会汇聚到单条链路,对网络收敛比要求更高。
- 逐流动态负载均衡(DLB flowlet):交换网络中较成熟的方案。在多条 ECMP 路径下,交换机基于本地链路带宽利用率、缓存水位等状态实时调整转发路径。但它的感知范围仅限本地,如下图中间所示,TOR1 发现 A 链路负载(70%)高于 B 链路(60%),优先选择 B 路径,结果 NIC1、NIC2 的流量在下游 Y 链路汇聚,反而造成拥塞。
- 全局逐流动态负载均衡(GLB):把负载感知的范围从单台交换机扩展到整个 Clos 网络。如下图右侧所示,TOR1 综合评估 A+X 与 B+Y 两条完整路径的负载后,判断 A+X 更优并选择 A 路径,从而避免了下游拥塞。
在交换机硬件实现的负载均衡能力之外,我们还提供了软件 HPN 的 ANC(Adaptive Network Congestion,自适应网络拥塞)控制器方案,对 HPN 网侧流量进行持续感知与动态调优。
任务启动后,ANC 控制器基于 Telemetry 实时采集网络状态信息、监测各链路拥塞情况;一旦发现热点流量,即可自动触发拥塞调度,将其分散至空闲路径。
实测数据显示:在 512 卡 AI 训练环境中,ANC 控制器可显著减少网络拥塞,将 HPN 网络吞吐提升 20%,使整体训练性能提升 4.3%;对于 NCCL 集合通信,相比传统 ECMP 方案,通信性能最高提升近 1 倍。
需要说明的是,端到端训练性能的提升幅度与模型中网络通信时间占比相关:通信占比越高,ANC 控制器带来的收益越明显。
4. 因地制宜:HPN 多平面优化的选型参考
HPN 多平面的负载均衡优化并不存在一套放之四海皆准的标准方案。客户在网络设施、软件栈成熟度和资源配置上存在差异,适用的优化策略也各不一样。
下表结合百度智能云的落地实践,梳理了各方案的成本、性能、部署难度与依赖条件,供政企客户搭建 HPN 多平面网络时参考。
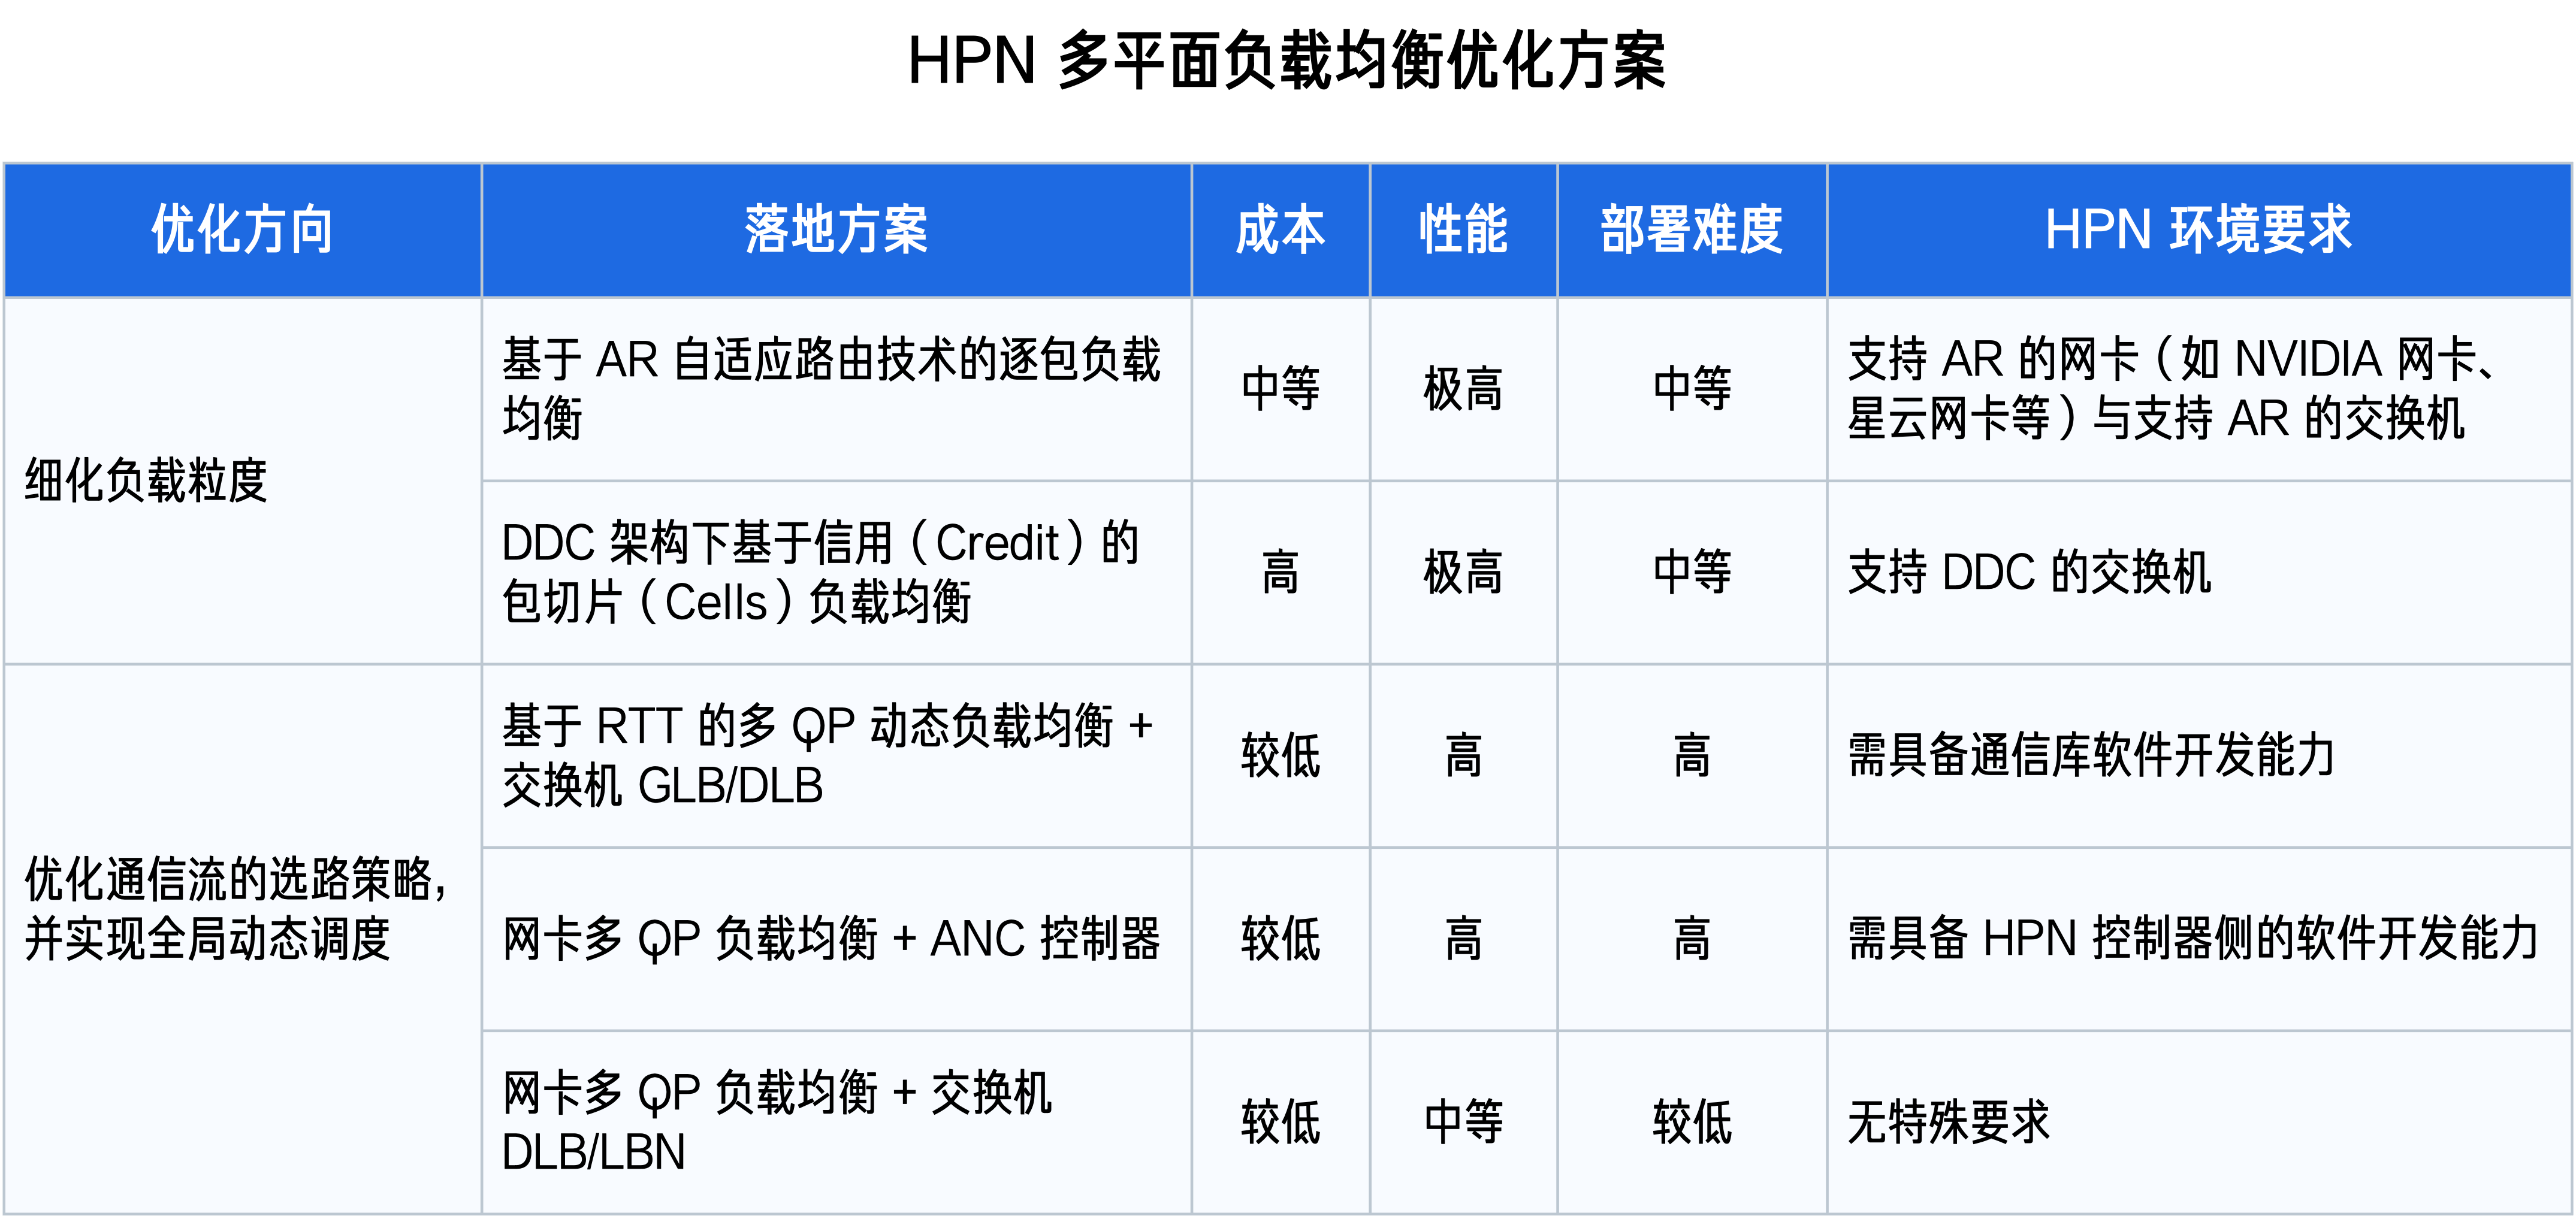
回到文章最初的问题:如何让 HPN 多平面的每一条路径都发挥价值?
说到底就是两条思路:一是细化负载粒度,把整条流拆到数据包、拆到 Cell,把同一条流「铺开」到多条路径上;另一条则是优化选路策略,在逐流的前提下,用多 QP 和路径编排提升路径的使用率,再通过 RTT 感知和 ANC 控制器实现全局动态调度。最终让 HPN 多平面的每一条路径得到更充分的利用,将多平面的网络资源转化为 AI 任务的通信效率。
相关文章推荐
发表评论
关于作者

- 被阅读数
- 被赞数
- 被收藏数
登录后可评论,请前往 登录 或 注册