
百度百舸第一时间适配 RLinf v0.4,持续建设具身智能 AI Infra 全链路能力
作者:xxinjiang2026.10.23 15:17浏览量:10简介:百度百舸第一时间适配 RLinf v0.4,持续建设具身智能 AI Infra 全链路能力
全球首个面向具身智能的大规模强化学习开源框架 RLinf 正式发布 v0.4 版本,围绕乐高式真机系统、高效率真机算法、全模态模型支持与国产算力底座四大方向系统性迭代。百度百舸在发布当天即完成适配并上线预置镜像。
开发者可通过百度百舸「快速开始」功能一键拉起 RLinf v0.4 通用镜像,Cosmos3 监督微调、ApxInf 评测 Pi0.5、仿真真机协同训练三个场景均已预置,开箱即用。
近日,全球首个面向具身智能的大规模强化学习开源框架 RLinf 正式发布 v0.4 版本,聚焦真实物理场景下的强化学习需求,推动具身强化学习从技术验证走向更高效、更灵活、可复现的真实机器人应用。百度百舸第一时间完成适配,并上线 RLinf v0.4 预置镜像与三个开箱即用的场景。开发者可依托百度百舸平台,一键应用 RLinf 的最新能力,实现前沿开源成果向产业生产环境的高效转化。
1. RLinf v0.4:重塑真机强化学习的工程与算法范式
RLinf 是具身智能行业广泛应用的强化学习底层开发平台,不到一年已完成 4 次版本更新:
- v0.1 版本(2025 年 12 月):建立强化学习系统抽象,显著提升复杂强化学习任务的开发与运行效率。
- v0.2 版本(2026 年 4 月):首次将机器人硬件与 GPU 纳入统一调度框架,实现异构机器人资源的自动发现与灵活调度。
- v0.3 版本(2026 年 7 月):首次完整打通数据采集、数据管理、监督微调(SFT)、强化学习(RL)、模型评测及真机部署的关键环节,形成从仿真训练到真机在线学习的统一开发闭环。v
- 0.4 版本(2026 年 10 月):进一步聚焦真实物理场景,围绕「乐高式真机系统、高效率真机算法、全模态模型支持、国产算力底座」四大核心方向展开系统性迭代,重塑真机强化学习的工程与算法范式。
RLinf 开源项目地址:https://github.com/RLinf/RLinf 具体来看,RLinf v0.4 的主要升级包括:
真机工程更模块化:全新模块化真机接口(rlinf.robotics)将机械臂、灵巧手、相机、移动底盘与遥操作外设抽象为即插即用的「乐高积木」,硬件驱动与任务逻辑彻底解耦,换本体、改构型或跨节点部署时,上层任务与策略代码「零改动」。双臂 Franka 打通 PICO VR 遥操作采集、双臂 HG-DAgger 在线训练与真机部署全流程,并新增双臂 YAM、AgileX Piper、SO-101 三款真机平台支持。
真机算法更高效:新增表征解耦在线强化学习(RLT)、零标注自监督离线强化学习(STEAM)、在线策略蒸馏(OPD)与异步实时控制(RTC)四项真机后训练算法,正面应对真机样本贵、标注难、推理卡顿三大难题。其中 OPD 在 LIBERO-Spatial 上仅需 30 步训练即可将成功率从 67% 提升至 96% 以上,RTC 将推理等待时间从数秒压缩至约 2 ms。
模型生态更丰富:从底层重写并与官方 JAX 实现逐算子数值对齐的 PyTorch 原生 OpenPI(Pi0/ Pi0.5),彻底解决原社区 PyTorch 版本的数值精度偏差与收敛性问题。新增 NVIDIA Cosmos3、FastWAM、Pi0-FAST、Evo-1、MolmoAct2 五款世界动作模型与 VLA 模型支持,并首次将强化学习能力拓展至 SD3、Wan2.2 图像与视频生成模型。
仿真评测更逼真:新增大规模家居操作基准 RoboCasa365 与真机链路仿真器(Real-World Simulator),可在仿真训练中注入真实传感器观测延迟与跨集群、边云网络带宽限制,让真机算法在进入物理实机前完成高保真回归验证。新增 SGLang 与 ApxInf 高速评测后端,Cosmos3 评测吞吐相比直接集成提升 3.33 倍。
系统底座更强韧:新增无损观测图像压缩,将图像网络传输负载降至原始大小的 36% 至 41%。升级集合通信张量压缩、权重重分片与异步权重同步机制,默认运行时升级至 PyTorch 2.11,支持全链路分布式 Tracing 与 Profiling。新增昆仑芯、壁仞、沐曦与 Intel XPU 后端,同一套训练栈已覆盖 NVIDIA、AMD 及 6 款主流国产与异构加速卡,并在华为昇腾与摩尔线程上实现最高 2.78 倍的吞吐提升。
生态与学术更活跃:RLinf 正式入选 PyTorch 官方生态,成为 NVIDIA Isaac Lab v3.0 官方集成的强化学习训练引擎。RLinf 团队的 WoVR 世界模型强化学习与 RL-Co 仿真真机协同强化学习两项成果被 CoRL 2026 接收,MoE 变换通信融合库 FUSCO 被 NSDI 2027 接收。
RLinf v0.4 详细信息,请访问 https://rlinf.readthedocs.io/zh-cn/latest/index.html
2. 在百度百舸上使用 RLinf v0.4:三个开箱即用的场景
RLinf v0.4 通用镜像已在百度百舸快速适配上线,预装 13 个模型的独立运行环境,支持多种主流 GPU 型号。开发者可通过「快速开始」功能在开发机一键拉起,省去繁琐的环境打包与软件部署。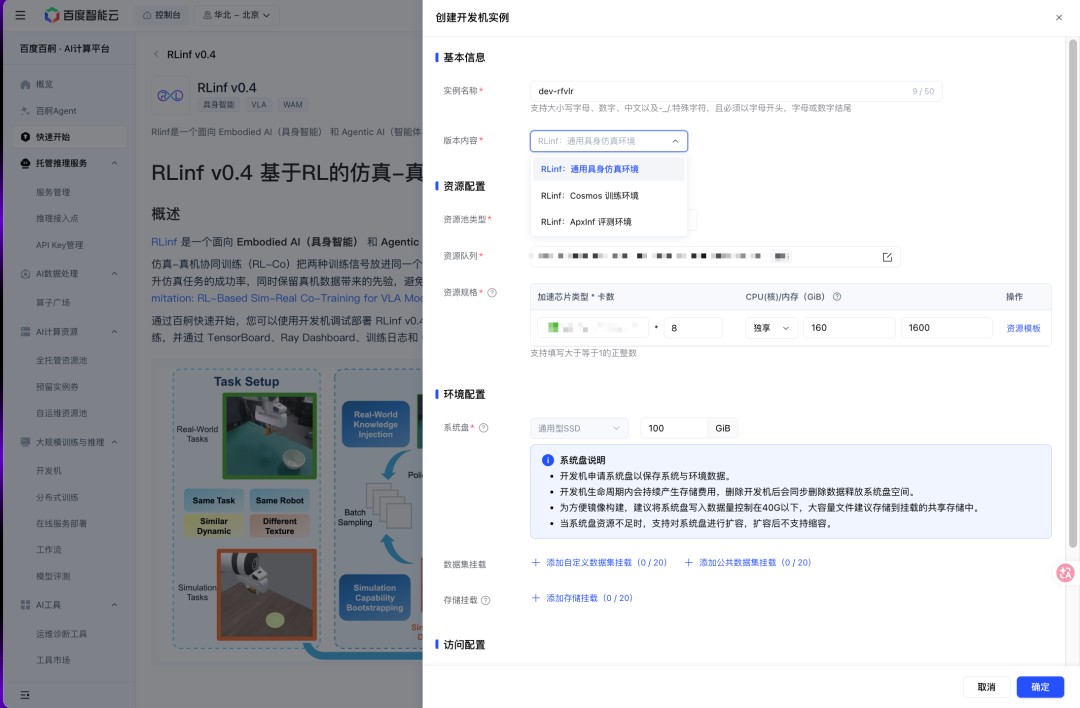
在完成 v0.4 适配的基础上,百度百舸进一步做了产品化工作:针对 v0.4 的新能力预置运行环境,并配套可直接跟着跑的场景文档,覆盖训练、评测与仿真真机协同三类任务:
在 LIBERO 上对 Cosmos3 做监督微调。以 NVIDIA Cosmos3-Nano 世界动作模型为基座,按 LIBERO 的动作空间做 SFT,得到可以直接在 LIBERO 仿真器中评测的策略模型。官方流程需要在通用环境之上另行安装 Cosmos3 代码与依赖,并下载配置 cosmos-framework,百度百舸已将这些步骤提前预置到镜像中。开发者在开发机上按「确认环境、准备基座模型与数据、启动 SFT 训练、转换 checkpoint」四步即可完成,基座模型权重可从百舸内网存储直接拉取,训练过程通过 TensorBoard、训练日志和 GPU 指标监控。https://cloud.baidu.com/doc/AIHC/s/nmvhjh2z6
基于 ApxInf 在 LIBERO 上评测 Pi0.5。RLinf v0.4 新增 SGLang 与 ApxInf 两个高速评测后端,其中 ApxInf 是通过 APXinf-robo 接口接入的进程内 Rust/CUDA 推理引擎,GPU 上的模型推理交给它执行,环境交互与前后处理仍由 RLinf 负责。官方方案需要自行编译 CUDA 绑定并安装到环境中,百度百舸镜像已预装运行环境与编译产物,开发者激活环境后即可直接在 LIBERO-10 上启动 Pi0.5 评测。单机 8 卡跑满 800 条轨迹,整轮评测约 12 分钟。https://cloud.baidu.com/doc/AIHC/s/pmvhpkbg7
基于强化学习的仿真真机协同训练。对应 RLinf 团队被 CoRL 2026 接收的 RL-Co 方法:在仿真环境中用 PPO 做强化学习,同时在真机轨迹上做 SFT,两种训练信号放进同一个优化循环,既提升仿真任务成功率,又保留真机数据带来的先验。开发者基于 ManiSkill 数字孪生环境与 50 条真机轨迹,即可对 Pi0.5 完成两阶段协同训练。百舸单机 8 卡实测 100 步,评测成功率从 50% 提升至 75%,与官方示例一致。https://cloud.baidu.com/doc/AIHC/s/6mvhdmd19
在此之上,结合百度百舸平台的 AI Infra 工程优化能力,上层各类具身模型的开发、训练与仿真可以获得显著的性能提速,大幅缩短模型迭代周期,充分释放算力资源的性价比。
3. 从数据管线到推理部署:百度百舸的具身智能全链路 AI Infra
具身智能正处在模型结构尚未收敛、技术路线频繁切换的阶段。开源社区负责推动算法创新,而决定模型能否进入生产环境、能否以合理成本完成训练的,是 AI Infra 的工程优化能力。
百度百舸通过系统性的 AI Infra 优化与高扩展性集群架构设计,致力于为各类具身智能场景找到高性价比的算力解决方案,把每一份算力更充分地转化为模型研发与迭代效率。
基于高性能计算、极致存储系统及超大规模高速互联网络,百度百舸 AI 计算平台已搭建起完整的具身智能工作流,覆盖从数据准备、开发训练、仿真验证到推理部署的研发全链路。
数据管线:例如,对第一视角(Egocentric)视频的相机位姿恢复管线做算子级优化,处理每小时视频所需的 GPU 时间最多下降 43%。对 VLA 与世界动作模型的 DataLoader 做全链路优化,FastWAM 单样本视频处理耗时缩短一半以上,让 GPU 不再等数据。
开发训练:例如,围绕 Cosmos 3 完成单机调优、512 卡 Scaling 与异构流水线三轮优化,MFU 达到 0.42,64 节点扩展效率 97.48%。基于 RLinf 精度对齐的 PyTorch 原生 OpenPI,将 Pi0.5 单机 8 卡训练吞吐提升 2.37 倍,256 卡线性扩展比保持 91% 以上。
仿真验证:例如,针对 Isaac、MuJoCo 等主流仿真生态做专项优化,Isaac Sim 任务启动时长减少 83.3%,Isaac Lab 相关场景 FPS 提升 43.9%。RLinf v0.3 发布当天完成首家适配,联合上海交通大学、地瓜机器人发布的 dVLA-RL 框架全部实验基于百度百舸平台完成。推理部署:例如,与上海交通大学穆尧团队合作的 AHA-WAM,单步动作推理延迟从 415 毫秒压缩至 41 毫秒。
目前,百度百舸已经服务超过 50 家具身智能产业链重点企业。未来,百度智能云将持续携手 RLinf 开源社区以及更多科研机构与产业伙伴,依托百度百舸 AI 计算平台的性能与 AI Infra 工程优化能力,共同加速具身智能产业的创新与规模化落地。
相关文章推荐
发表评论
关于作者

- 被阅读数
- 被赞数
- 被收藏数
登录后可评论,请前往 登录 或 注册