
百度智能云联合哈工大提出 VLDA,机器人操作从预测未来转向学习变化
作者:xxinjiang2026.11.04 15:20浏览量:17简介:百度智能云联合哈工大提出 VLDA,机器人操作从预测未来转向学习变化
近日,百度智能云联合哈尔滨工业大学(深圳)提出面向机器人操作(robotic manipulation)的新范式 VLDA(Vision-Language-Delta-Action,视觉-语言-变化-动作),并在百度百舸开源的训练框架 LoongForge 中同步开放了完整训练实现。
这项工作针对的是具身智能领域的一个长期痛点:现有模型要么从观察直接映射到动作、把「该改变什么」隐含在动作监督里,要么耗费大量容量去预测整幅未来画面。VLDA 的解法是只学「任务相关的那一点状态变化」(Delta),并让它直接参与动作生成。在 LIBERO、LIBERO-Plus、RoboTwin 2.0 三个仿真基准和两套真机平台上,VLDA 相比基线获得显著提升。
代码地址:https://github.com/baidu-baige/LoongForge/tree/master/cookbook/loongforge-vlda
项目主页:https://baidu-baige.github.io/LoongForge/projects/vlda.html
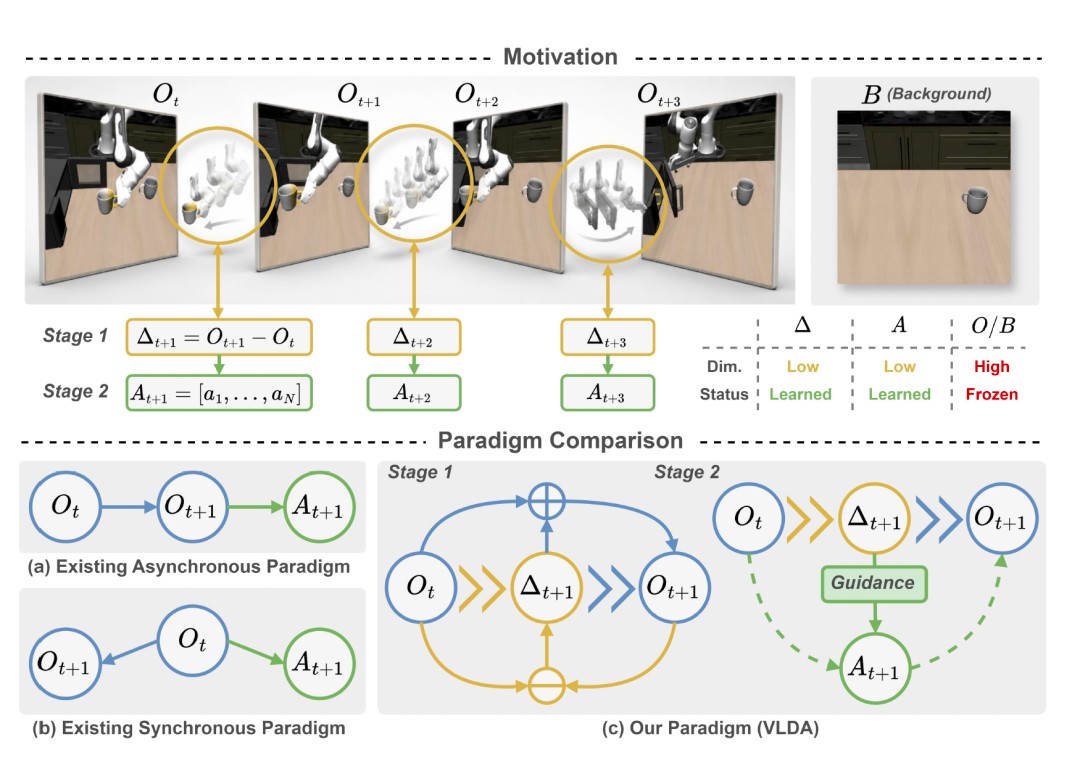
机器人操作的本质,不是「看到什么就输出什么动作」,而是「把世界的某个状态改变到想要的样子」。VLDA 把这个问题重新定义了一遍:不去预测完整的未来状态(full-future prediction),而是学一个紧凑的中间变量 Delta,专门描述「与任务相关的那一点状态变化」,再用它去引导动作生成(action generation)。
在这套思路下,VLDA 在仿真与真机上都取得了当前最好的成绩,其中 GALAXEA R1 Lite 平台的真机平均成功率 73.0%,比强基线 π0.5 高出 17.0 个百分点。而它最关键的证据是一个消融实验:仅仅把「学变化」换回「预测完整未来」,LIBERO 性能就掉了 0.7 个百分点,在考察鲁棒性的 LIBERO-Plus 上更是掉了 3.4 个百分点。
这个结果之所以值得单独拿出来讲,是因为它触及了具身智能的一个核心争论:机器人模型到底该不该去「想象未来」。
过去两年,用世界模型(world model)预测未来帧来辅助控制,被普遍视为提升泛化的主要方向,代价是模型容量要分给大量的静态画面。VLDA 给出的答案是,未来帧该用,但不该整幅地去预测,只该从中提取「变化」这一件事。
1. 机器人操作真正该学的变量是什么
先看一个常见的操作任务:把两个玩具放进篮子,再把篮子移到蓝色垫子上。
对人类来说,这件事的难点很明确:哪些物体要动、要动成什么样、怎么动。但画面里绝大部分内容其实是不动的:桌面、墙面、没被碰到的物体,从头到尾没有变化。真正与任务相关的状态变化,往往只占画面里很小的一块区域。
由此,现有的两条技术路线就有各自的局限。
第一条是 VLA(Vision-Language-Action,视觉-语言-动作模型)的直接映射路线。它从观察出发直接生成动作,让一个策略同时承担三件事:认出该操作哪个物体、推断目标状态该是什么样、生成可执行的动作序列(action chunk)。这三件事挤在同一个端到端(end-to-end)过程里,语义理解和动作执行之间缺少一个专门的接口,学习负担很重,任务一旦变长就难以优化。这条路线还从没有显式地建模过「任务相关的状态变化」本身:策略只能从动作监督信号里间接地反推「到底要改变什么」,这个反向推断的过程没有明确的约束,也就难以保证它推出的是正确的物理变化。
第二条是 WAM(World-Action Model,世界-动作模型)的「预测未来」路线。它通过预测未来观测、未来视觉潜变量(visual latent)或动作条件下的动力学(action-conditioned dynamics),为控制提供超出当前帧的时间线索,这比只看当前帧确实多了一层信息。问题在于,它预测的是完整的未来状态,于是任务相关的转移线索和静态场景内容、和动作无关的变化全部纠缠在一起,模型的容量被迫分散到大量与任务无关的细节上。更要紧的是,未来预测在多数实现里只作为辅助目标(auxiliary objective)存在,它虽然给控制提供了上下文,却没有变成一个能直接指挥动作生成的结构化中间变量:控制效果如何,取决于架构里具体的融合方式,而不是取决于这个「未来」本身。
两条路线的共同缺口,是都缺少一个「与动作真正挂钩的、只描述任务相关物理转移」(task-relevant transition)的表示。VLDA 的出发点正在这里:既然机器人要做的是一次受控的状态变换,那就应该把这个变换本身当成核心决策变量来学,而不是让它隐含在动作监督里、或者淹没在整幅未来预测里。
顺着这个判断,一个理想的转移表示应该同时满足三条:
它要有选择性(selective),只挑出任务相关的操作区域,不被静态背景带偏;
它要有预测性(predictive),方向与未来整体走势一致,而不是抓住某个局部细节;
- 它还要可执行(actionable),能直接为动作生成所用,而不是一个只供观看的中间表征。VLDA 把这三条要求具化成三个部件。
2. 核心思路:用一个紧凑的 Delta 当转移接口
VLDA 的做法,是引入一个低维的 Delta 变量,充当视觉语言理解和动作生成之间的「转移接口」(transition interface)。
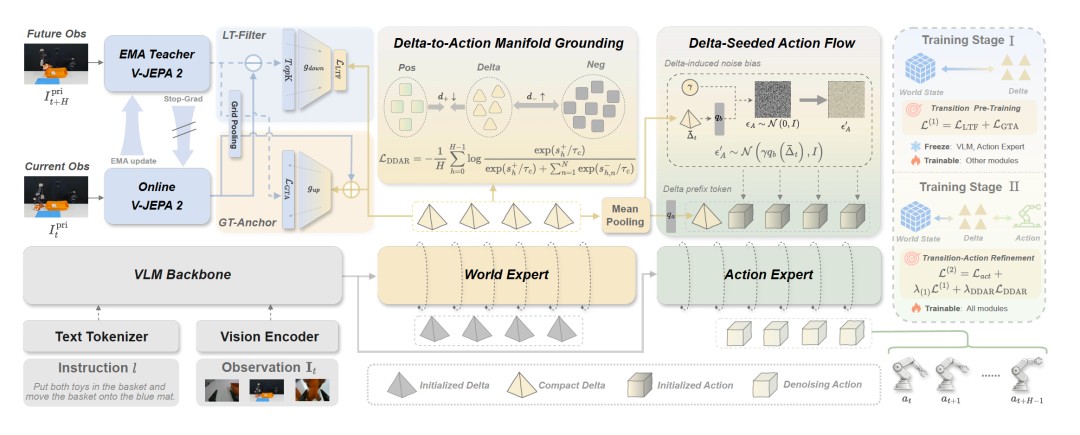
整个动作生成过程被拆成三步:视觉语言模型(Vision-Language Model,VLM)先编码当前状态和语言指令,得到多模态上下文(multimodal context);世界专家(World Expert)据此推断出 Delta,也就是「需要发生什么变化」;动作专家(Action Expert)再以 Delta 为条件,把这个变化落实成一段可执行的动作序列。原来的「观察到动作」一步到位,被改写成「理解、转移、执行」的闭环。关键在于,Delta 是这条链路里唯一的、显式的物理变化变量:训练时它由未来状态监督,推理时它不需要未来状态,只由当前观测和指令推断出来。理解一侧产出的是「要做什么」,执行一侧需要的是「怎么动」,中间的 Delta 就是这两者之间的翻译层。
那为什么不直接从指令生成动作,而要多加这一层。理解与执行两个任务的信息性质不同:理解是语义层面的,需要判断「这件事是什么」;执行是物理层面的,需要知道「这一刻该出力到哪儿」。直接在两者之间建立映射,等于要求模型在同一个表示空间里同时容纳语义和物理两种结构,而这两者并没有整齐的对应关系。Delta 的作用是把物理层面的意图单独拎出来,让语义一侧只需要输出「变化应该是什么」,不必操心「变化怎么实现」,执行一侧只需要实现给定的变化,不必重新理解任务。
这个 Delta 要立得住,必须同时满足前面那三条要求,VLDA 用三个部件分别对应。
局部转移滤波器(Local Transition Filter,LT-Filter)解决「选得准」的问题。它对当前帧和未来帧提取稠密语义特征,算出两者的差异,然后只挑出变化幅度最大的前 K 个区域(Top-K)作为监督目标,把没动的背景直接丢掉。论文里 K 取 64,实验表明从 16 增加到 64 稳步提升,再加到 100 则不再有收益。这样一来,Delta 的目标里天然只有任务相关的转移证据,不会被大量静态冗余稀释。由于这些被选出的区域是无序的(unordered set),方法用带熵正则的最优传输(entropy-regularized optimal transport,Sinkhorn)来建立软对应关系,保证匹配过程不受索引顺序影响:同一个位置集合,无论以什么顺序排列,都会得到一致的监督。消融实验显示,换成逐点 MSE 或 Chamfer 距离,平均成功率分别为 97.2% 和 97.8%,而最优传输匹配能到 98.5%。
全局转移锚(Global Transition Anchor,GT-Anchor)解决「看得全」的问题。只用局部选择会有一个风险:Delta 可能过度聚焦于某个局部变化,丢掉整体的转移方向,比如只盯着手边的一个物体,却忽略了整段任务的空间走向。GT-Anchor 额外引入一份粗糙的未来演化摘要作为正则约束,保证 Delta 既能解释局部变化,又能解释未来的整体趋势。一个管局部选择性,一个管全局一致性,两者互补。
Delta 驱动的动作精修(Delta-Driven Action Refinement,DDAR)解决「用得上」的问题,它由两个子模块组成:
- 其一是 Delta-动作流形对齐(Delta-to-Action Manifold Grounding,DAMG):通过对比学习把 Delta 和真实动作对齐,把当前动作块里的真实动作作为正样本,把同一条轨迹里其他时段的动作作为负样本,让 Delta 的表示向「与当前动作一致」的方向靠拢。这一步的意义在于,Delta 光「视觉上说得通」还不够,因为画面变化和动作不一定一一对应,模型完全可能学到一个视觉上很准、但对控制没有指导价值的表示。
- 其二是 Delta 播种的动作流(Delta-Seeded Action Flow,DSAF):把对齐后的 Delta 作为结构化的种子注入动作生成过程,一路作为动作噪声的偏置改写流匹配(flow matching)的初始点,一路作为 Delta 前缀 token(prefix token)贯穿整个去噪过程。消融实验表明两条支路各有贡献:只用噪声偏置为 97.9%,只用前缀 token 为 97.6%,两者合用才到 98.5%。到这一步,Delta 就不再只是辅助监督信号,而是真正介入了动作的生成。
3. 训练:两阶段,先把变化学好,再联合优化
VLDA 的实现放在开源训练框架 LoongForge 上完成,模型本体搭建在 π0.5 之上(PaliGemma 初始化的 20 亿参数视觉语言骨干 + Gemma-300M 动作专家),并新增一个与动作专家同架构、同容量但从零初始化的世界专家。
LoongForge 面向大规模基础模型(foundation model)和具身模型(embodied model)训练,提供模块化的模型、数据和训练器抽象,支持 DDP、ZeRO-1、FSDP、HSDP 等分布式训练方式,也支持按组件冻结参数、检查点管理(checkpoint management)和实验日志。这些能力让 VLDA 的分阶段优化可以在一套流水线里完成,而不需要为每个阶段另搭一套工程。训练分两个阶段:
第一阶段只学转移(transition pre-training,转移预训练),动作分支冻结,单独优化 LT-Filter 和 GT-Anchor 两个目标,目的是先把 Delta 的表示学稳。
第二阶段联合优化转移建模、动作生成和 Delta 与动作的对齐,让三者互相配合,避免动作分支的梯度在一开始就干扰到尚未成形的转移表示。
在监督信号的构建上,VLDA 借鉴 V-JEPA 2 的思路,用了一个在线编码器处理当前观测、一个指数移动平均(Exponential Moving Average,EMA)教师处理未来观测的非对称设计。这样做的原因是:如果当前帧和未来帧的特征都由快速变化的编码器产生,Delta 的目标就会建立在两个同时漂移的特征空间之间,今天学到的「变化」明天就失效了,监督信号不稳定。让未来一侧由一个缓慢演化的教师提供,目标空间就稳定了,Delta 学到的是相对固定的「变化是什么」,而不是两个动态系统之间的差值。
推理时只需要当前观测和指令,不需要未来观测。世界专家先采样出 Delta,动作专家再用它引导去噪生成动作,整个「理解、转移、执行」的分解被完整保留。更进一步,两个 V-JEPA 2 编码器以及只用于构造转移目标和做对齐的投影模块在训练结束后即可丢弃,部署时只需要视觉语言骨干、世界专家、条件化模块和动作专家。这一点对落地很关键:训练时可以拿到未来帧,部署时拿不到,如果方法依赖未来观测,就用不起来。
4. 实验:三个仿真基准加两套真机
论文在 LIBERO、LIBERO-Plus、RoboTwin 2.0 三个仿真基准(simulation benchmark)上评测,另在 GALAXEA R1 Lite 和 AgileX Cobot Magic 两套真机平台上验证。训练在单机 8 张 NVIDIA A800-SXM4(80 GB)上完成,真机推理在单张 32 GB 消费级 GPU 上进行。
LIBERO 是操作任务的经典基准。VLDA 平均成功率 98.5%,在四个任务套件(task suite)上分别为 Spatial 99.8%、Object 99.6%、Goal 99.4%、Long 95.2%,均为当前最好成绩。相比 π0.5 基线,四个套件分别提升 1.0、1.4、1.4、2.8 个百分点。在这个已经接近饱和的基准上,长时任务套件 Long 的 2.8 个百分点提升幅度最大,说明 Delta 的收益主要落在需要多步连贯操作的任务上。
LIBERO-Plus 考察鲁棒性和泛化。这个基准在相机、机器人本体、语言、光照、背景、噪声、布局七个维度上做扰动(perturbation),检验模型在训练分布之外的稳定性。VLDA 在其中做零样本(zero-shot)评测,共 10030 次 rollout,平均成功率 84.5%,比 π0.5 基线高 10.9 个百分点,比最强基线 GuidedVLA(75.4%)高 9.1 个百分点。在难度更高的 Long 套件上,领先幅度扩大到 13.4 和 12.1 个百分点。值得注意的是光照维度:VLDA 达到 96.0%,是全部维度里最高的一项,说明它对视觉外观变化的耐受度较强;这正好印证了 LT-Filter 的作用:只学该变的地方,就不容易被光照这类不改变任务本质的外观变化带偏。
RoboTwin 2.0 考察跨分布泛化。VLDA 只在干净(clean)设置下训练,在随机化设置下评测,构成零样本测试。在论文精选的 10 个 hard 任务上,VLDA 平均成功率 62.9%,比 π0.5(42.7%)高 20.2 个百分点,十项逐一取得最优或并列最优;在全部 50 个任务上,VLDA 平均 50.86%,比最强基线 π0.5(43.84%)高 7.02 个百分点。增益在复杂状态转移任务上尤其明显:Put Bottles Dustbin 高出 46 个百分点,Stacking Three 高出 30 个,Place Dual Shoes 和 Open Microwave 各高出 27 个。这些任务的共同点是需要模型理解「把什么放到哪里」这类多步状态变化,而 Delta 恰好是为这类变化建模的。
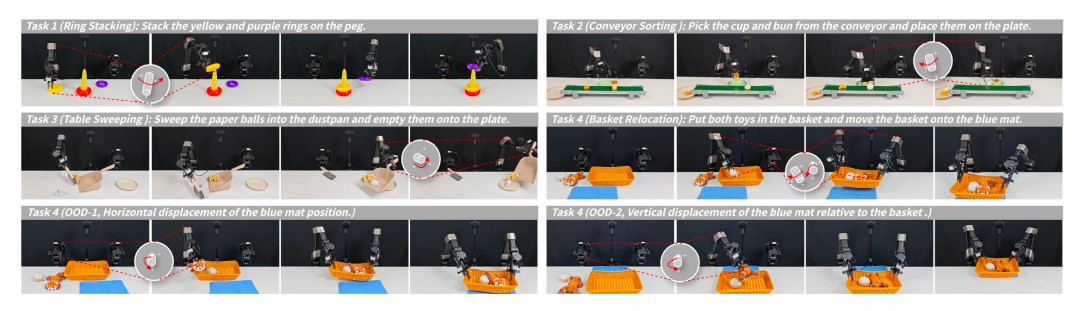
真机评测覆盖四个长时(long-horizon)任务:叠环、桌面清扫、传送带分拣、篮子搬运,每个任务每个平台各 25 次试验,按累积检查点(progressive checkpoint)逐步记录完成阶段。在 GALAXEA R1 Lite 平台上,VLDA 平均成功率 73.0%,比 π0.5(56.0%)高 17.0 个百分点,比 OpenVLA-OFT(16.0%)高 57.0 个百分点;在 AgileX Cobot Magic(ALOHA)平台上,VLDA 平均 72.0%,比 π0.5(54.0%)高 18.0 个百分点,比 OpenVLA-OFT(17.0%)高 55.0 个百分点。更能说明问题的是末段表现:四个任务里 VLDA 在后期阶段的成功率掉得比基线少,长时一致性(long-horizon consistency)更好。篮子搬运一项还专门测试了空间泛化(spatial generalization),数据采集时随机化垫子位置,评测时给出分布外(out-of-distribution,OOD)的目标位置,VLDA 在最后的放置阶段仍保持 72% 的成功率,比基线高 24 个百分点。这条结果最能体现 GT-Anchor 的价值:局部操作要准,整体空间走向也要对,两者缺一不可。
5. 消融:为什么「只学变化」比「预测整幅未来」更好
VLDA 最有说服力的证据来自消融实验。把 Delta 建模换回「预测完整未来」(full-future prediction),LIBERO 性能从 98.5% 掉到 97.8%,而在考察分布偏移(distribution shift)的 LIBERO-Plus 上从 84.5% 掉到 81.1%,其中光照维度掉 6.9 个百分点、背景掉 4.7 个。这个差距本身就回答了论文开篇提出的问题:与其让模型把容量花在静态外观和无关变化上,不如让它集中学任务相关的状态变化。这个结论的价值不在于 LIBERO 上那 0.7 个百分点,而在于它给出了一个可以推广的判断:在同样的模型规模下,一个更聚焦的中间表示,比一整套完整的未来预测更能提升控制效果——而且越是考察泛化,差距越明显。
其余消融也逐项印证了各个部件的价值。去掉 Delta 播种的动作流(DSAF),平均成功率从 98.5% 掉到 97.2%,说明把 Delta 真正注入动作生成、而不只是当作辅助监督,是收益的关键一步。去掉 Delta 与动作的流形对齐(DAMG),LIBERO 上从 98.5% 掉到 98.2%,而 LIBERO-Plus 平均掉 2.5 个百分点,其中光照维度从 96.0% 掉到 89.7%、背景掉 3.7 个百分点:一旦 Delta 失去动作层面的约束,它就更容易被画面本身的变化牵着走。LT-Filter 和 GT-Anchor 单独使用都有提升,两者合用效果最好,且篮子搬运这类布局变化大的任务上增益最突出(真机成功率从 48% 提升到 72%),印证了局部选择性和全局一致性对变布局场景同样关键。此外,如果取消转移预训练、在训练一开始就联合优化所有模块,LIBERO 性能会掉到 97.3%,LIBERO-Plus 更是掉到 79.4%,说明分阶段训练对稳定地建立转移表示是必要的。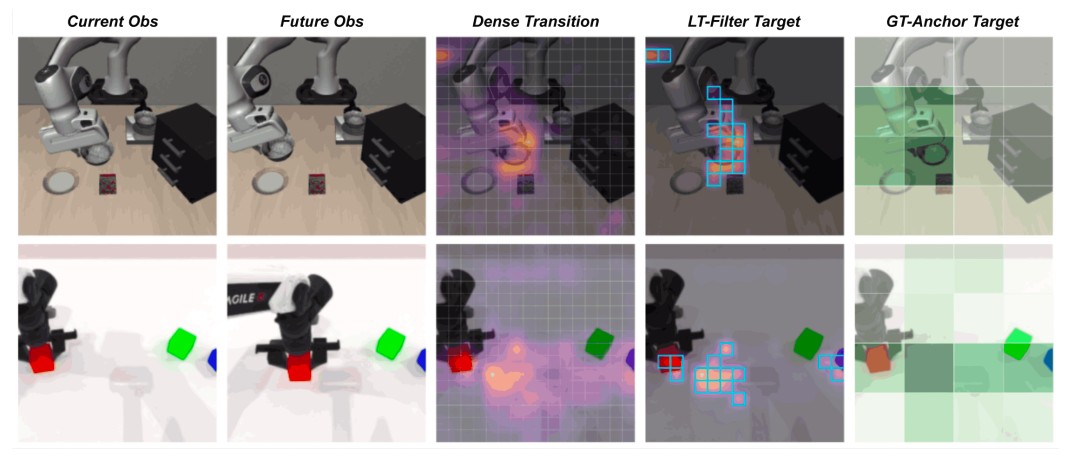
6. 总结
VLDA 的意义在于换了一个建模对象。它不再让模型直接学「观察映射到动作」,也不再让它预测完整的未来状态,而是把「任务相关的状态变化」提炼成一个紧凑的中间变量,并让它直接参与动作生成。这一改动同时提升了几项此前难以兼顾的指标:长时一致性、分布偏移下的鲁棒性、以及对新场景的泛化能力。
从这个结果往回看,机器人操作的学习难点,或许并不在于模型不够大,而在于一个隐含的表示缺口:语义理解和动作执行之间,长期缺少一个专门的、可执行的「变化」变量。VLDA 提供了一种解法,也给出了一个判断依据:一个更聚焦的中间表示,比一整套完整的未来预测更能提升控制效果。
相关文章推荐
发表评论
关于作者

- 被阅读数
- 被赞数
- 被收藏数
登录后可评论,请前往 登录 或 注册